最終更新日 2026年9月25日 8:30
最終更新日 2026年9月25日 8:30
エルミタ的速攻撮って出しレビュー Vol.1695
2026.09.25 更新
文:撮影・編集部 池西 樹


|
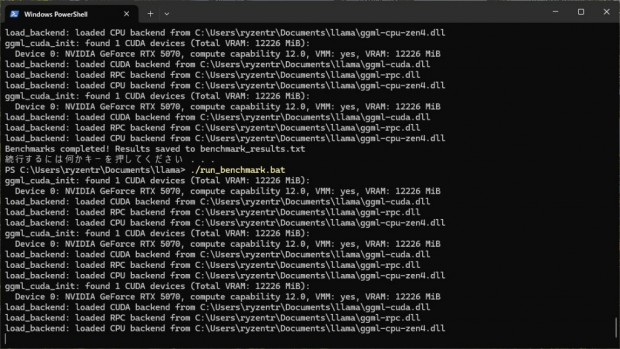
ベンチマークの締めくくりとして、大規模言語モデル(LLM)の推論環境として広く使われている「llama.cpp」を使用し、メインメモリの帯域や容量が実際のテキスト生成速度に与える影響を検証していこう。今回は「Llama-3.1-8B」「Qwen2.5-32B」「Llama-3.3-70B」の3種類のモデル(いずれもQ4_K_M量子化)を用意し、GPU(GeForce RTX 5070 12GB)のVRAMに収まりきらないレイヤーをCPU・メインメモリ側へオフロードして計測を実施した。
|
|
|
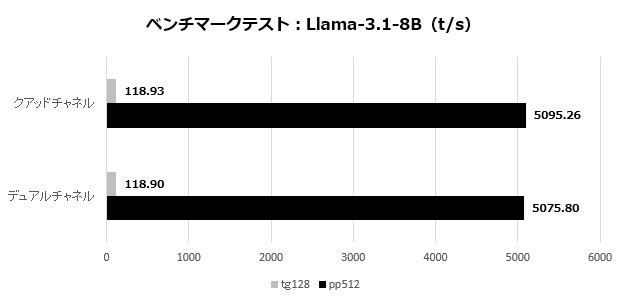
データサイズが約4.6GBとVRAM内で処理が完結する「Llama-3.1-8B」では、プロンプト処理(pp512)、テキスト生成(tg128)のいずれにおいてもスコアに大きな差は見られなかった。
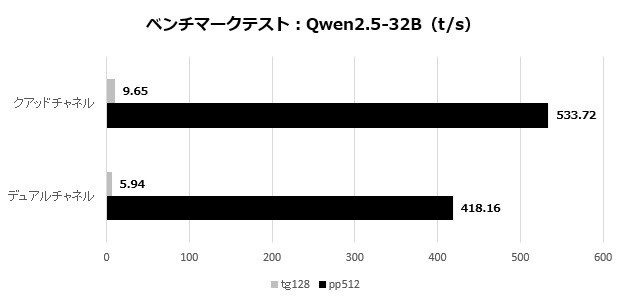
しかし、データサイズが約18.4GBとVRAM容量を超過し、メインメモリへのオフロードが発生する「Qwen2.5-32B」では、クアッドチャネルがデュアルチャネルに比べてpp512で約27%、tg128で約62%向上し、大きく上回る結果となった。
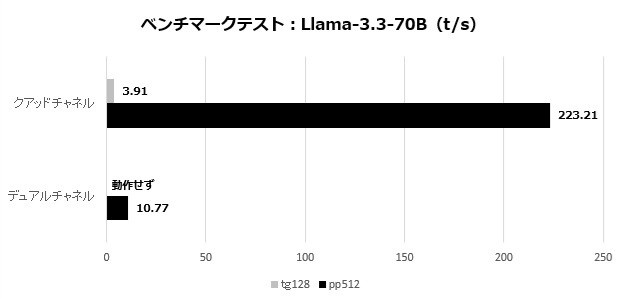
さらにデータサイズが約42.5GBに達する「Llama-3.3-70B」では、帯域幅の違いに加えて、デュアルチャネルではメモリ容量が32GB、クアッドチャネルでは64GBという容量差も影響して、pp512では約20倍もの大差がついた。また、tg128ではデュアルチャネルでは処理が完了しなかった。
この結果から、大規模なLLMをローカル環境で運用する場合には、広いメモリ帯域に加え、使用するモデルに応じた十分なメモリ容量の確保が重要になる。
今回は、v-color「ECC R-DIMM」シリーズと64コア/128スレッドを誇るRyzen Threadripper PRO 9985WXによるパフォーマンスを検証してきた。
「Cinebench 2024/2026」による3Dレンダリングや「Adobe Photoshop」による複雑な画像処理など、マルチスレッドに最適化されたクリエイティブな作業では大きく性能が向上した。また、AI処理の中でもCPU主導の作業や、GPUのVRAM容量を超える大型LLMによる推論においては、クアッドチャネルによる広いメモリ帯域が性能向上に寄与することが確認できた。また、十分なメモリ容量を確保することも重要になる。
|
「R-DIMM」メモリは一般的なPCパーツショップでの取り扱いが少なく、直近では他ブランド製品も含めて入手性が悪化しているという話も耳にする。しかしv-color製品であれば、国内正規代理店である株式会社アユートを通じて購入や導入の相談ができるのは心強いポイントだ。R-DIMMの購入を検討しているなら、まずはv-colorを取り扱っている販売店やアユートへ問い合わせてみるといいだろう。
v-color「ECC R-DIMM」シリーズは、本格的なワークステーションや高負荷なローカルAI環境において、メニーコアCPUのメモリ帯域によるボトルネックを緩和し、そのパフォーマンスを引き出すための有力な選択肢になる。また、Ryzen Threadripper PROをベースとしたシステムで、より性能を重視するならオクタチャネル構成を検討するのもいいだろう。
提供:株式会社アユート
v-color Technology Inc.