最終更新日 2026年9月25日 8:30
最終更新日 2026年9月25日 8:30
エルミタ的速攻撮って出しレビュー Vol.1695
2026.09.25 更新
文:撮影・編集部 池西 樹


|
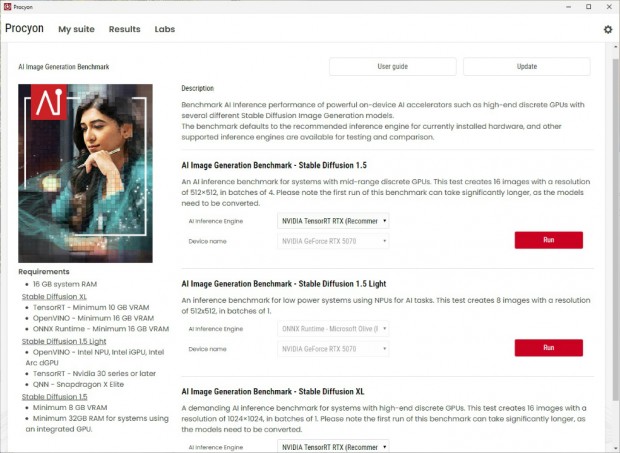
ここからはいよいよ、注目のAI処理性能をチェックしていこう。まずはGPUへの依存度が非常に高いAI画像生成ベンチマーク「Procyon AI Image Generation Benchmark」のスコアから確認していく。
|
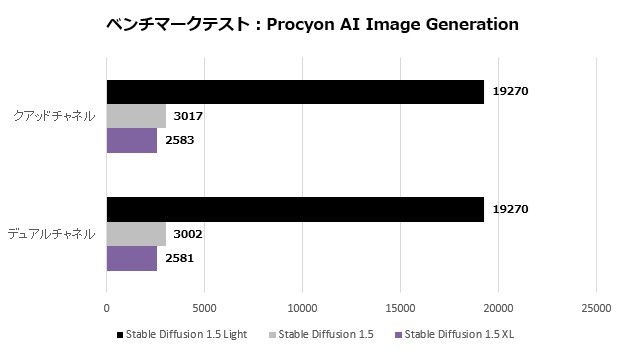
本テストはGPU依存度が高いことに加え、最も処理負荷の高い「Stable Diffusion XL」を実行した場合であっても、今回検証に使用したGeForce RTX 5070 12GBのビデオメモリにデータがすべて収まる。そのため、デュアルチャネルとクアッドチャネルではスコアに大きな違いは出なかった。
|
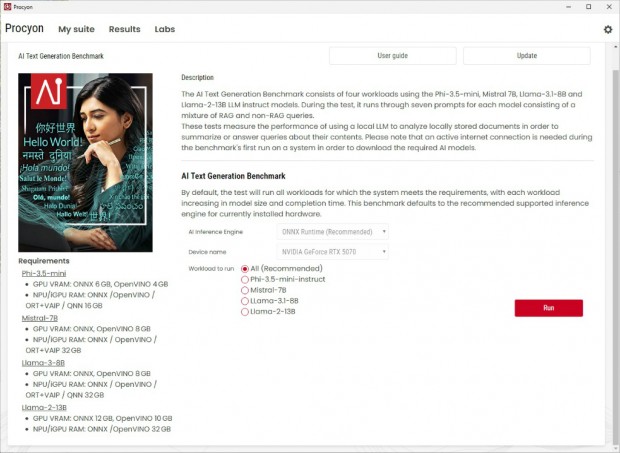
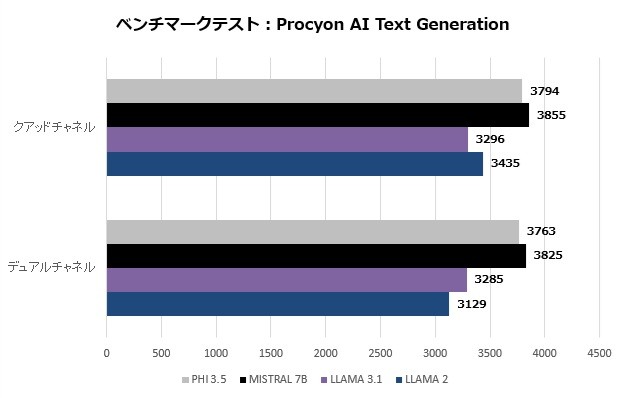
続いて、AIテキスト生成ベンチマーク「Procyon AI Text Generation Benchmark」のスコアも確認しておこう。
|
こちらも基本的にはGPU依存度が高く、「Phi-3.5-mini」「Mistral-7B」「Llama-3-8B」といったモデルサイズの比較的小さい条件では、デュアルチャネルとクアッドチャネルでスコアに明確な差は見られなかった。しかし、モデルサイズが大きくなり、メインメモリも使用する「Llama-2-13B」のテストにおいては、クアッドチャネルがデュアルチャネルよりも約10%高いスコアをマークした。
|
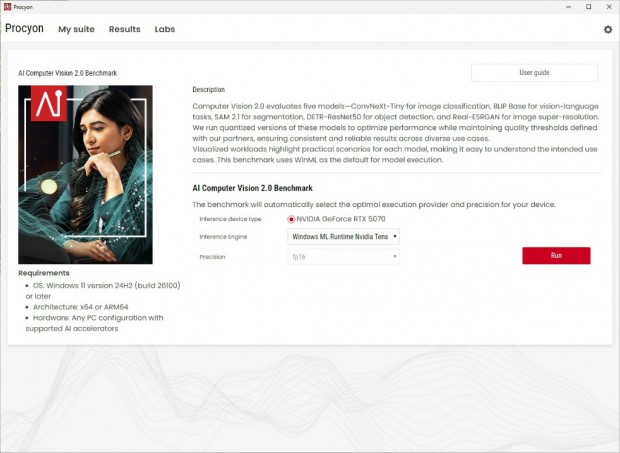
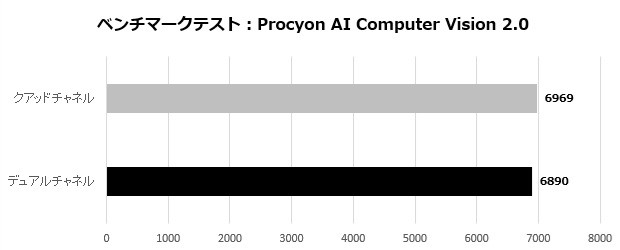
最新のAIモデルを使用した、画像認識や物体検出などマシンビジョン系AI処理の性能を評価する「Procyon AI Computer Vision Benchmark 2.0」のスコアを確認していこう。
|
NPUでの処理にも対応する軽量なワークロードであることに加え、データがすべてVRAM内に収まるため、メインメモリの帯域による影響を受けにくい。そのため、デュアルチャネルとクアッドチャネルでのスコア差は約1%にとどまり、ほぼ横並びの結果となった。
|
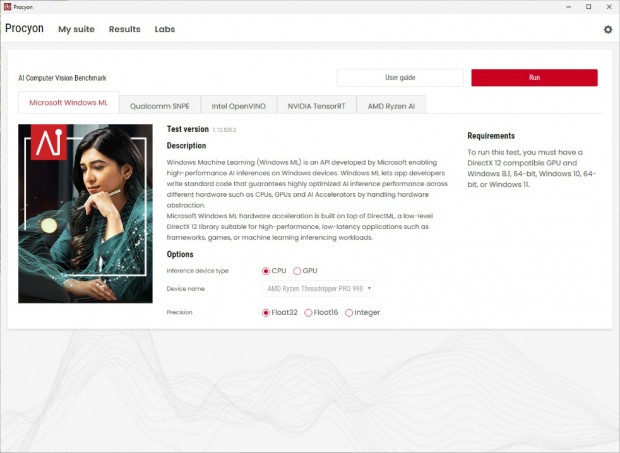
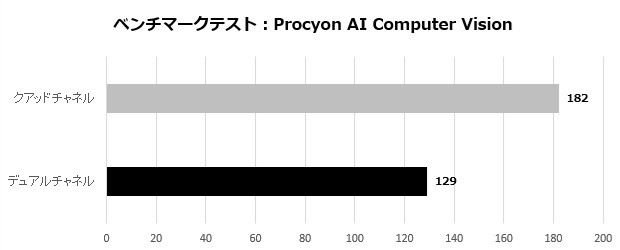
続いて、同じくマシンビジョン系AI処理の性能を計測する「Procyon AI Computer Vision Benchmark」のスコアを確認していこう。推論エンジンは「Microsoft Windows ML」、推論デバイスにはCPU(Ryzen Threadripper PRO 9985WX)を指定し、精度「Float32」にてテストを実行した。
|
デュアルチャネルの129に対し、クアッドチャネルでは182を記録し、約41%も性能が向上した。今回の結果では、CPUによる推論処理でメモリ帯域の拡大による大きな性能向上が確認できた。